Entre fechar o formulário e rodar o primeiro teste existe uma etapa que nenhum orientador explica e que consome mais tempo do que a análise em si: transformar a exportação bruta em um banco de dados que o software estatístico aceite. A maior parte dos travamentos que parecem ser “problema do programa” na verdade é uma planilha mal montada — e todos eles são evitáveis em uma tarde.
Passo 1 — O retângulo: uma linha, um respondente
Software estatístico não lê planilha bonita; lê retângulo. A estrutura obrigatória é:
- Uma única linha de cabeçalho, na linha 1. Nada de título da pesquisa, logotipo da faculdade ou linha em branco acima dela.
- Uma linha por respondente, da linha 2 em diante, sem interrupções.
- Uma coluna por variável, sem colunas em branco separando blocos de perguntas.
- Zero células mescladas. Mesclagem é formatação para leitura humana e destrói a leitura por máquina.
- Nenhuma linha de total, subtotal ou média dentro da área de dados. Se você calcular, calcule fora do retângulo ou em outra aba.
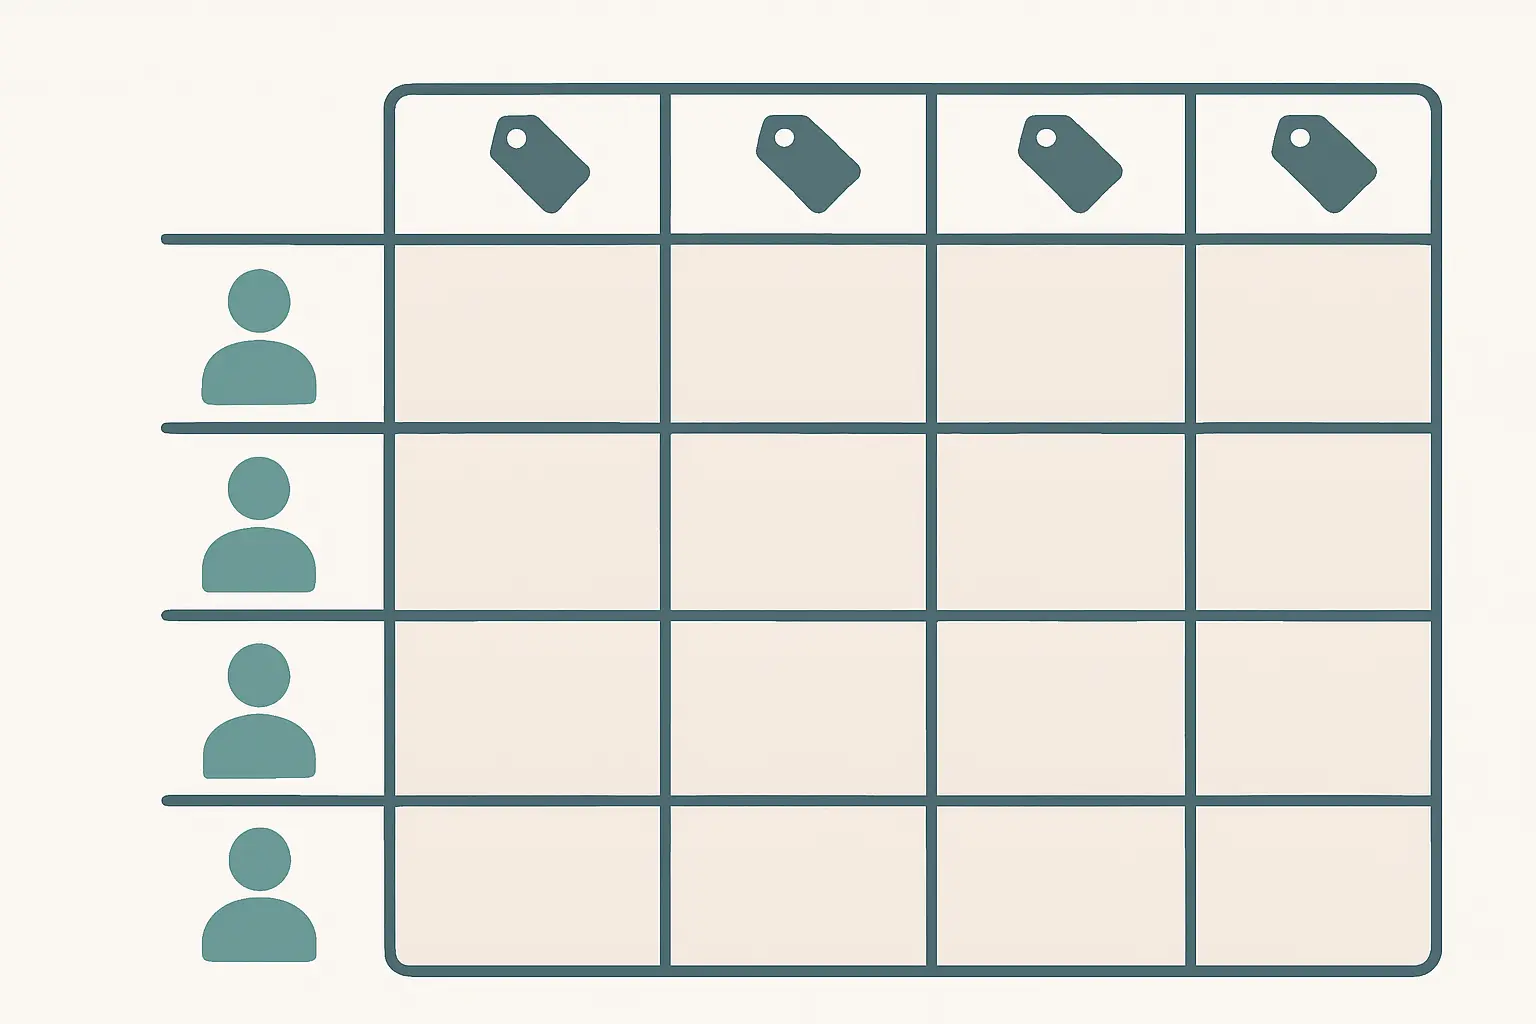
Acrescente uma coluna de identificador logo no início — 1, 2, 3… — antes de mexer em qualquer coisa. Ela não entra em análise nenhuma, mas permite voltar ao questionário original quando um valor parecer estranho, e é o que torna possível conferir uma exclusão meses depois.
Passo 2 — Renomear as colunas
O Google Forms exporta o enunciado inteiro da pergunta como cabeçalho. Uma coluna chamada “Em uma escala de 1 a 5, o quanto você concorda com a afirmação: sinto-me reconhecido pelo meu gestor?” é inutilizável em qualquer programa.
Renomeie seguindo quatro regras que evitam problemas em todos os softwares:
- Curto e descritivo:
reconhec_gestor, nãoP17nem o enunciado inteiro. Nomes puramente numéricos tornam a leitura da saída um exercício de decodificação. - Sem espaços — use o sublinhado.
- Sem acentos, cedilha ou caracteres especiais. Eles funcionam em algumas versões e falham em outras, e o erro aparece só na exportação final.
- Nunca começando com número. Vários programas rejeitam
1_idadee aceitamidade_1.
Para blocos de escala, mantenha um prefixo comum e numere: satisf_01 a satisf_08. Isso permite selecionar o bloco inteiro de uma vez na hora de calcular consistência interna, em vez de caçar item por item na lista.
Passo 3 — Criar o dicionário de variáveis
Assim que você renomeia as colunas, o enunciado original se perde — e é ele que você vai precisar para escrever o capítulo de resultados. A solução é uma aba à parte, chamada dicionario, com uma linha por variável e cinco colunas:
| Campo | Conteúdo | Exemplo |
|---|---|---|
| Nome | O nome curto usado no cabeçalho | reconhec_gestor |
| Enunciado | A pergunta exatamente como o respondente leu | “Sinto-me reconhecido pelo meu gestor” |
| Tipo | Nominal, ordinal ou contínua | Ordinal |
| Códigos | O que cada número significa | 1 = discordo totalmente … 5 = concordo totalmente |
| Ausente | Como o valor faltante foi marcado | Célula vazia |
Esse documento tem três usos concretos: permite escrever o capítulo sem reabrir o formulário, permite retomar a análise meses depois sem adivinhar, e responde na hora à pergunta de banca “o que exatamente significa a variável X da sua tabela 4?”. Custa vinte minutos e é a diferença entre um banco de dados e um monte de números.
Passo 4 — Codificar as categóricas
Variáveis categóricas devem virar números com rótulos, e não texto livre. Duas razões: alguns procedimentos exigem código numérico, e texto digitado à mão produz categorias fantasma — “Feminino”, “feminino”, “F” e “Fem ” são quatro categorias diferentes para o programa.
- Padronize antes de codificar. Rode um filtro ou uma tabela de frequência sobre a coluna de texto e veja quantas variantes existem. É onde os espaços em branco no fim da célula aparecem.
- Nunca misture texto e número na mesma coluna. Uma única célula com “não sei” em uma coluna numérica converte a coluna inteira em texto, e a variável some das análises numéricas.
- Registre os códigos no dicionário, sempre. E, ao importar no software, aproveite o editor de variáveis para atribuir os rótulos — as tabelas de saída passam a sair legíveis, sem retrabalho de digitação.
- Cuidado com a opção “Outro”. Ela chega como texto livre e costuma conter respostas que pertencem a categorias já existentes. Recodifique caso a caso e crie a categoria “Outros” apenas para o que sobrar.
Passo 5 — Perguntas de marcar várias alternativas
Esta é a armadilha silenciosa da exportação. Uma pergunta do tipo “marque todas que se aplicam” volta como uma única coluna de texto com as opções separadas por vírgula. Nesse formato, ela não serve para absolutamente nada.
A conversão correta é uma coluna binária por alternativa: midia_instagram, midia_whatsapp, midia_email, cada uma com 1 quando marcada e 0 quando não marcada. A partir daí cada alternativa vira uma variável analisável, e o percentual de cada opção sai de uma tabela de frequência simples.
Um cuidado de leitura: como cada respondente pode marcar várias, a soma dos percentuais passa de 100%. Isso não é erro, mas precisa ser dito na nota da tabela, seguindo as convenções descritas em como apresentar números e tabelas estatísticas no TCC.
Passo 6 — Recodificar os itens invertidos
Escalas bem construídas incluem itens redigidos na negativa para reduzir o viés de aquiescência. Se você somar o escore sem recodificá-los, o resultado é um número sem significado — e a consistência interna despenca de forma inexplicável.
A recodificação é aritmética simples: em uma escala de 1 a 5, o valor recodificado é 6 menos o valor original; em uma escala de 1 a 7, é 8 menos o original. A regra geral é somar o mínimo e o máximo da escala e subtrair o valor.
Crie uma coluna nova — satisf_04r — em vez de sobrescrever a original. Três vantagens: a recodificação fica auditável, um erro pode ser desfeito, e você consegue conferir se aplicou a inversão a todos os itens que precisavam e apenas a eles. Registre no dicionário quais itens foram invertidos.
Um item invertido esquecido é, de longe, a causa mais comum de um coeficiente de confiabilidade inexplicavelmente ruim; a assinatura é uma correlação item-total negativa, e o diagnóstico está detalhado em alfa de Cronbach ou ômega de McDonald.
Passo 7 — Calcular o escore da escala
Com os itens recodificados, crie a coluna do escore. Duas decisões a tomar e a declarar:
- Soma ou média dos itens? A média tem a vantagem de manter o escore na mesma escala dos itens — um escore 3,8 em uma escala de 1 a 5 é imediatamente interpretável. A soma é mais comum quando o instrumento original prevê pontos de corte por pontuação total. Siga o que o autor da escala determinou; na ausência de instrução, a média é mais legível.
- O que fazer quando faltam itens? Defina antes: por exemplo, calcular o escore apenas para quem respondeu a todos os itens, ou aceitar até um item ausente e usar a média dos respondidos. O que não pode é a planilha decidir sozinha — funções de média ignoram células vazias silenciosamente, e um respondente que preencheu três de oito itens acaba com um escore aparentemente válido.
O escore somado ou médio é uma variável contínua, ao contrário dos itens que o compõem, que são ordinais. Essa distinção decide quais análises fazem sentido e está discutida em escala Likert no TCC.
Passo 8 — Marcar os dados faltantes
A regra é curta: célula vazia. Não escreva zero, porque zero é um valor observado e entra no cálculo da média. Não escreva “NA”, “não respondeu” nem traço, porque texto em coluna numérica converte a coluna inteira em texto.
Se o seu procedimento pede um código numérico — 99, 999 —, ele precisa ser declarado como valor ausente dentro do software antes de qualquer análise. Um 99 não declarado entra na conta como se fosse uma idade de 99 anos, e o estrago é invisível na saída.
Antes de seguir, conte quanto falta em cada variável. Ausências espalhadas ao acaso e em pequena proporção são irrelevantes; concentração de não resposta em uma pergunta específica é um achado sobre o instrumento e merece um parágrafo. O tratamento das ausências e a decisão sobre casos completos estão em posso excluir outliers dos dados do TCC.
Passo 9 — Limpar registros inválidos
Quatro verificações resolvem quase toda a triagem, e as quatro devem ser feitas com critério declarado — nunca depois de ver o resultado do teste:
- Duplicatas. Mesmo respondente enviando duas vezes. Compare os carimbos de data e hora e o conjunto de respostas.
- Tempo de resposta implausível. Se o formulário registra o horário de início e de envio, um questionário de 40 itens respondido em 50 segundos não foi lido.
- Padrão invariante. A mesma alternativa marcada em todos os itens, inclusive nos invertidos, indica preenchimento mecânico.
- Critérios de inclusão. Quem não pertence à população definida sai por regra, não por julgamento — os critérios já deveriam estar escritos, conforme critérios de inclusão e exclusão na pesquisa.
Registre cada bloco de exclusão em uma aba de log: quantos casos, por qual motivo, em que data. Esse registro é o que permite escrever o n original e o n final com segurança na metodologia.
Passo 10 — As duas cópias e o formato de saída
Mantenha duas cópias, sempre: a exportação original, intocada, com o nome que deixa claro que ela é a bruta, e a base de trabalho, onde toda a limpeza acontece. Se algo der errado na recodificação — e vai —, você refaz a partir do original em vez de refazer a coleta.
Nomeie os arquivos com data no formato ano-mês-dia, que ordena sozinho: 2026-09-18_base_trabalho_v3.xlsx. Isso resolve o problema clássico do arquivo chamado “final_final_agora_vai”.
Para exportar: CSV ou XLSX resolvem a maioria dos casos. Se escolher CSV, salve em UTF-8 para preservar os acentos e confira se o separador decimal do arquivo corresponde à configuração do programa que vai ler — vírgula lida como ponto transforma coluna numérica em texto, que é o sintoma mais frequente de “a variável não aparece na análise”. Com o arquivo pronto, o caminho de importação e definição dos tipos de medida está em Jamovi passo a passo.
Um último ponto que não é técnico: se a base contém dados de participantes, ela é objeto das obrigações discutidas em LGPD na pesquisa de TCC. A coluna de identificação pessoal — nome, e-mail, matrícula — deve sair da base de trabalho e ficar, se necessária, em um arquivo separado e protegido.
Checklist antes de importar
- Cabeçalho na linha 1, único, sem células mescladas.
- Coluna de identificador criada.
- Nomes de coluna curtos, sem espaço, sem acento, não começando com número.
- Aba de dicionário preenchida.
- Categóricas padronizadas e codificadas, sem texto em coluna numérica.
- Perguntas de múltipla marcação convertidas em colunas binárias.
- Itens invertidos recodificados em colunas novas.
- Escores calculados com regra declarada para itens ausentes.
- Faltantes como célula vazia, ou código declarado no software.
- Registros inválidos removidos, com log de exclusões.
- Base bruta preservada em arquivo separado.
- Coluna de dados pessoais removida da base de trabalho.
- Arquivo salvo em CSV UTF-8 ou XLSX, com separador decimal conferido.
Feita essa preparação, a análise deixa de ser uma sequência de erros do programa e vira o que deveria ser: alguns cliques. E, quando as tabelas estiverem prontas, o trabalho que sobra é escrever — parte em que o Tesify ajuda, estruturando o texto do TCC a partir do seu próprio material, com referências ABNT automáticas e autoverificação de originalidade.
Perguntas frequentes
Como deve ser a estrutura da planilha de dados do TCC?
Um retângulo simples: uma única linha de cabeçalho na primeira linha, uma linha por respondente e uma coluna por variável. Sem título acima do cabeçalho, sem células mescladas, sem linhas de total no meio e sem colunas em branco separando blocos.
O que é o dicionário de variáveis?
É uma aba à parte que registra, para cada coluna, o nome curto usado no cabeçalho, o enunciado completo da pergunta, o tipo de medida, os códigos usados e o que representa um valor ausente. É o que permite retomar a análise meses depois e responder à banca sem adivinhação.
Como marcar as respostas que faltam?
Deixe a célula vazia. Não escreva zero, porque zero é um valor observado e entra no cálculo da média. Se preferir um código como 99, ele precisa ser declarado como valor ausente dentro do software antes de qualquer análise.
Como codificar uma pergunta de marcar várias alternativas?
Crie uma coluna binária para cada alternativa, com 1 para marcada e 0 para não marcada. Guardar todas as escolhas em uma única coluna separada por vírgulas produz uma variável de texto que nenhum teste consegue usar.
Preciso recodificar os itens invertidos?
Precisa, antes de somar qualquer escore ou calcular consistência interna. Crie uma coluna nova para o valor recodificado em vez de sobrescrever a original: assim a recodificação é auditável e um erro pode ser desfeito.
Qual formato de arquivo usar para importar no software?
CSV ou XLSX resolvem a maioria dos casos. Se optar por CSV, salve em UTF-8 para preservar os acentos e confira se o separador decimal corresponde à configuração regional do programa que vai ler o arquivo.
Posso analisar direto na planilha do Google Forms?
Não é recomendável. A planilha de respostas é a base bruta e continua recebendo envios; qualquer edição feita nela é irreversível e mistura coleta com tratamento. Trabalhe sempre em uma cópia, preservando o original intocado.