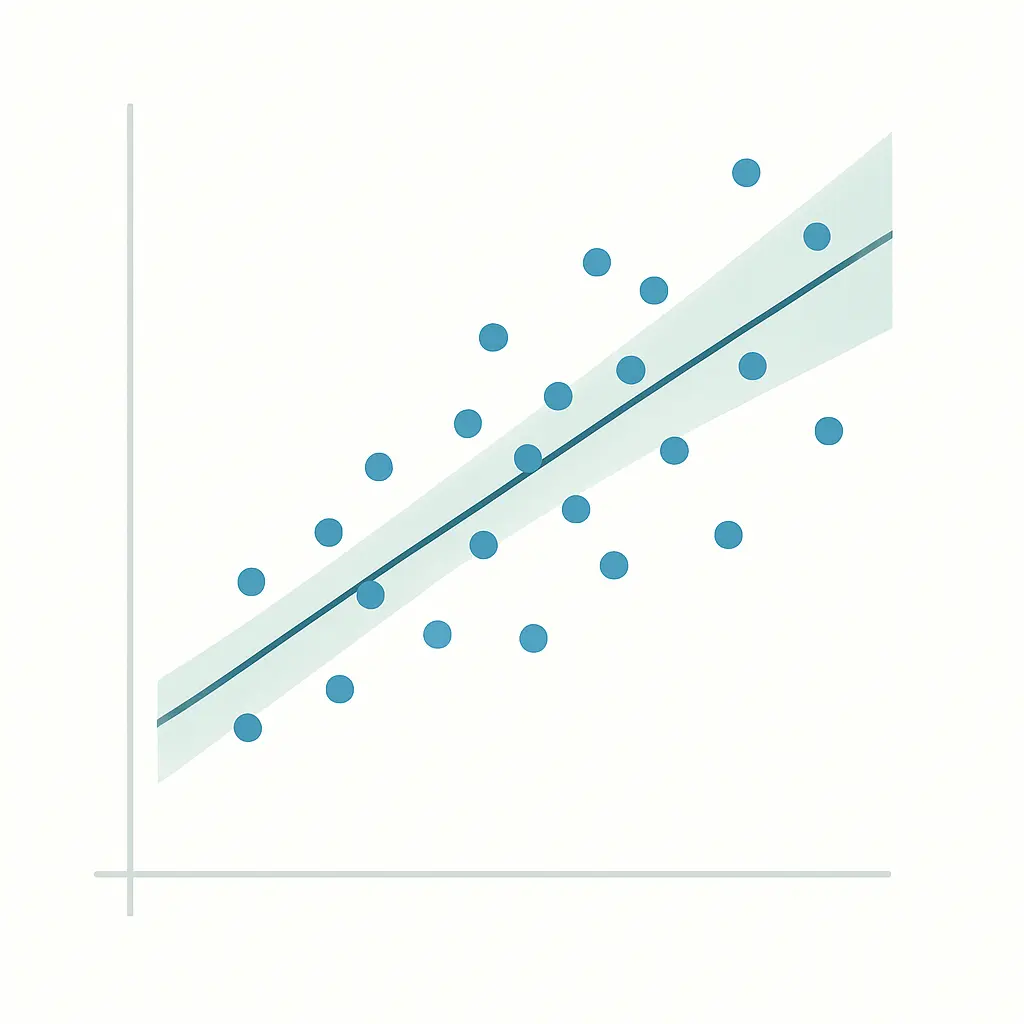
A regressão linear responde a uma pergunta que a correlação não responde: quanto uma variável explica de outra, e o que sobra de efeito depois de descontar as demais. Ela entra no TCC quando o objetivo é prever ou explicar um desfecho numérico — nota, faturamento, tempo de permanência, escore de uma escala — a partir de um ou mais fatores. Antes de rodar, porém, o modelo exige cinco pressupostos, e o mais mal compreendido deles não é sobre os seus dados: é sobre os resíduos.
Quando a regressão responde à sua pergunta
A escolha entre correlação e regressão não é de sofisticação, é de pergunta. A correlação responde “essas duas variáveis andam juntas?” e devolve um número simétrico: a correlação de X com Y é idêntica à de Y com X. A regressão responde “quanto de Y é explicado por X?” e é assimétrica — ela assume que uma variável ocupa o papel de desfecho e a outra o de preditor.
Essa assimetria só faz sentido se você já definiu qual variável é dependente e qual é independente, o que é uma decisão teórica, não estatística. Se essa distinção ainda está confusa no seu projeto, resolva-a antes em variáveis da pesquisa: dependente e independente. Rodar regressão com os papéis trocados produz uma saída perfeitamente válida do ponto de vista do software e completamente sem sentido do ponto de vista da banca.
Use regressão quando a sua pergunta tiver uma destas formas:
- Explicação: “que fatores explicam a satisfação dos clientes?”
- Previsão: “é possível prever a nota final a partir da frequência e das horas de estudo?”
- Controle: “o efeito do treinamento sobre a produtividade se mantém depois de descontar tempo de casa e escolaridade?”
O terceiro caso é o que mais justifica a regressão em um TCC, porque é o único que a correlação não consegue fazer. Se a sua pergunta for apenas de associação, a correlação é suficiente — e mais fácil de defender. O guia de decisão sobre qual teste estatístico usar situa a regressão entre as demais opções.
Regressão simples ou múltipla
A regressão linear simples tem um preditor. A múltipla tem dois ou mais, e é ela que aparece na maioria dos TCCs quantitativos, porque quase nenhum fenômeno social tem uma causa só.
A diferença prática está na interpretação. Na regressão múltipla, cada coeficiente é lido mantendo os demais preditores constantes. Essa cláusula não é enfeite: ela é a razão de existir do modelo. Dizer que “horas de estudo aumentam a nota em 0,4 ponto” é diferente de dizer que “horas de estudo aumentam a nota em 0,4 ponto, controlando frequência e escolaridade dos pais” — a segunda afirmação é muito mais forte e é a que o seu modelo autoriza.
Uma advertência de escopo: se a sua variável dependente for categórica (sim/não, aprovado/reprovado), a regressão linear não se aplica; o modelo correto é a regressão logística, que tem outra saída e outra interpretação. E se a dependente for uma escala do tipo Likert de item único, há discussão legítima na literatura sobre tratá-la como numérica — o assunto está em escala Likert no TCC.
Quantos respondentes você precisa
Esta é a pergunta que aparece tarde demais, quando a coleta já fechou. A referência mais citada para regressão múltipla é Green (1991), no artigo How Many Subjects Does It Take To Do A Regression Analysis? (Multivariate Behavioral Research, v. 26, n. 3, p. 499-510), que propõe duas regras de bolso distintas conforme o que você quer testar:
| Objetivo | Regra | Com 3 preditores | Com 5 preditores |
|---|---|---|---|
| Testar o R² do modelo como um todo | N ≥ 50 + 8m | 74 | 90 |
| Testar cada preditor individualmente | N ≥ 104 + m | 107 | 109 |
Sendo m o número de preditores. Note que a segunda regra é quase sempre a mais exigente, e é ela que vale se você pretende afirmar que um determinado fator é significativo — que é justamente o que a maioria dos TCCs quer afirmar.
São aproximações, não leis. Elas assumem um efeito de tamanho médio e não substituem um cálculo formal de poder, que leva em conta o efeito esperado na sua área. Mas servem para uma decisão binária muito útil antes da coleta: com 40 respondentes e 5 preditores, o modelo não vai sustentar conclusão sobre preditor nenhum, e é melhor descobrir isso agora. O planejamento da amostra está detalhado em população e amostra no TCC.
Os cinco pressupostos e como checar cada um
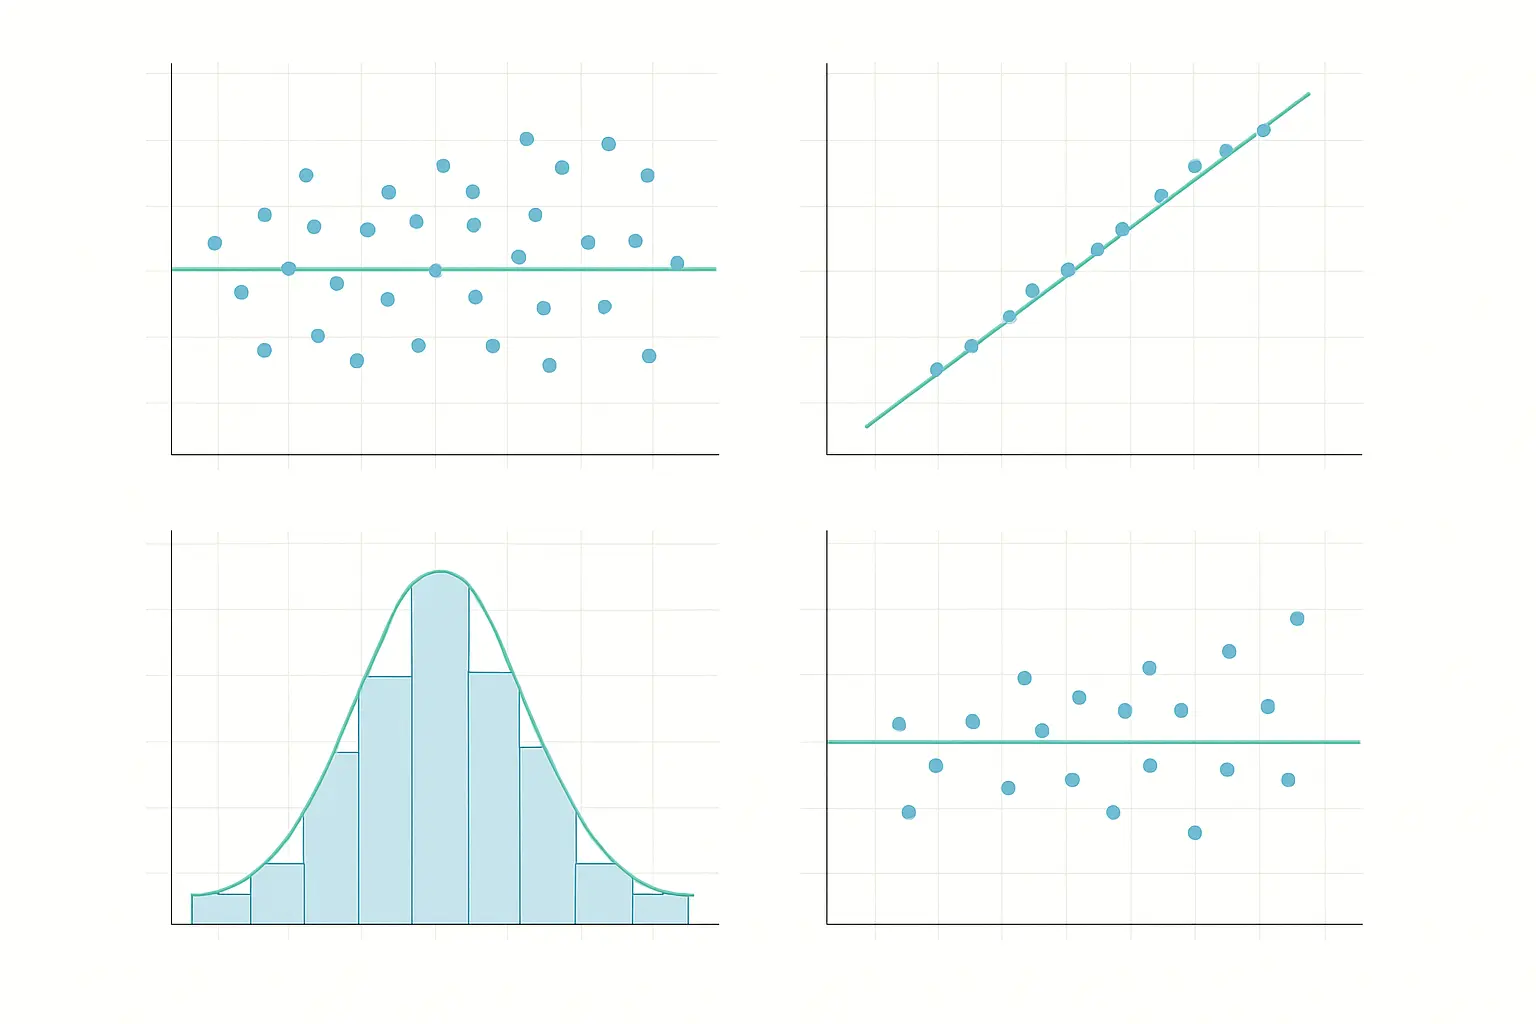
Aqui está o ponto que mais gera erro em TCC, e vale enunciá-lo antes da lista:
A regressão linear não exige que as suas variáveis tenham distribuição normal. Ela exige que os resíduos do modelo — a diferença entre o valor observado e o valor previsto — sejam aproximadamente normais. São coisas diferentes. É perfeitamente possível ter uma variável dependente assimétrica e resíduos bem comportados, e o contrário também acontece. Rodar um teste de normalidade na variável bruta, ver que ela falha e concluir “não posso usar regressão” é um erro frequente e evitável, porque o teste foi aplicado ao objeto errado.
| Pressuposto | O que significa | Como checar | Se falhar |
|---|---|---|---|
| Linearidade | A relação entre preditor e desfecho é uma reta, não uma curva | Gráfico de dispersão de cada preditor com o desfecho; resíduos versus valores previstos sem padrão curvo | Transformar a variável (log, raiz) ou incluir termo quadrático |
| Independência dos resíduos | O erro de um caso não informa o erro de outro | Garantido pelo desenho amostral; estatística de Durbin-Watson próxima de 2 em dados ordenados no tempo | Modelo que trate o agrupamento (medidas repetidas, dados aninhados) |
| Homocedasticidade | A dispersão dos resíduos é constante ao longo dos valores previstos | Resíduos versus previstos: nuvem em faixa horizontal, sem funil | Erros-padrão robustos ou transformação da dependente |
| Normalidade dos resíduos | Os erros se distribuem em torno de zero de forma aproximadamente normal | Histograma dos resíduos e gráfico Q-Q | Com amostra razoável, o modelo é robusto a desvios moderados |
| Ausência de multicolinearidade | Os preditores não medem a mesma coisa | VIF e tolerância | Remover ou combinar preditores redundantes |
Some-se a isso a inspeção de casos influentes: um único respondente atípico pode puxar a reta inteira. A distância de Cook é o indicador usual, e um caso que a domina merece ser examinado e comentado — nunca apagado em silêncio.
O gráfico de resíduos versus valores previstos é o mais eficiente do conjunto: sozinho, ele diagnostica linearidade e homocedasticidade ao mesmo tempo. Se a nuvem parecer uma faixa horizontal sem forma, os dois pressupostos estão de pé. Se parecer um funil que abre para a direita, há heterocedasticidade. Se parecer uma banana, a relação não é linear.
Todos esses diagnósticos saem prontos em qualquer dos programas usuais — a comparação entre eles está em SPSS, R, Jamovi ou Excel para analisar dados do TCC.
Multicolinearidade: o VIF
Multicolinearidade acontece quando dois ou mais preditores carregam praticamente a mesma informação — renda familiar e classe social, por exemplo, ou duas subescalas que medem facetas do mesmo construto. O modelo continua rodando, o R² continua alto, mas os coeficientes individuais ficam instáveis: os erros-padrão inflam, os p-valores sobem e preditores que deveriam ser significativos deixam de ser.
O sintoma clássico, e que costuma assustar quem o encontra pela primeira vez: o modelo é significativo como um todo, mas nenhum preditor é significativo isoladamente. Quase sempre é multicolinearidade.
O indicador é o VIF (fator de inflação da variância), que mede o quanto cada preditor é explicado pelos demais. As convenções mais usadas:
- VIF próximo de 1 — sem problema.
- VIF acima de 5 — atenção; parte da literatura já considera preocupante.
- VIF acima de 10 — multicolinearidade séria pelo critério mais tradicional.
A tolerância é simplesmente o inverso do VIF, de modo que tolerância abaixo de 0,10 equivale a VIF acima de 10. São convenções de campo, não pontos de corte demonstrados: relate o valor obtido e o critério que adotou, em vez de apenas afirmar que “não houve multicolinearidade”.
Quando o VIF acusa problema, a saída raramente é estatística — é conceitual. Se dois preditores medem a mesma coisa, o modelo está dizendo que você tem uma variável, não duas. Escolha a que tem melhor sustentação teórica, ou combine-as em um índice, e justifique a decisão na metodologia. Esse tipo de sobreposição costuma ter origem na construção do instrumento, assunto tratado em validade e confiabilidade da pesquisa.
Como ler a saída: R², B, beta e p
A saída de qualquer software traz dezenas de números. Quatro decidem a leitura:
R² — quanto o modelo explica
É a proporção da variação do desfecho que o conjunto de preditores explica. R² = 0,32 significa que o modelo dá conta de 32% da variação, e que 68% vêm de fatores fora dele. Não existe um valor universalmente “bom”: em ciências humanas e sociais, valores entre 0,10 e 0,30 são comuns e publicáveis, porque comportamento humano tem muitas causas simultâneas; em contextos experimentais bem controlados espera-se mais. A referência correta é o que a literatura da sua área relata, não um número decorado.
R² ajustado — o R² com penalidade
O R² sempre sobe quando você acrescenta um preditor, mesmo que seja ruído puro. O R² ajustado desconta essa inflação em função do número de preditores e do tamanho da amostra. Em regressão múltipla, é o ajustado que se relata. Se ele cair ao acrescentar uma variável, essa variável está piorando o modelo.
B — o coeficiente não padronizado
É a mudança no desfecho para cada unidade a mais no preditor, mantendo os demais constantes. Vem na unidade original: “cada hora semanal de estudo a mais se associa a 0,4 ponto a mais na nota”. É o número que se usa na frase interpretativa, porque é concreto.
Beta — o coeficiente padronizado
Expressa o mesmo efeito em desvios-padrão, o que o torna comparável entre preditores medidos em unidades diferentes. É o beta que responde à pergunta “qual fator pesa mais?” — comparar Bs de variáveis em escalas distintas é um erro de leitura comum.
E o p-valor de cada coeficiente indica se o efeito daquele preditor difere de zero. Como em qualquer teste, ele não mede a importância do achado: com amostra grande, efeitos triviais alcançam significância. Relate também o intervalo de confiança do coeficiente, que informa a precisão da estimativa e é bem mais útil do que o p sozinho.
Como relatar no capítulo de resultados
O relato mínimo aceito em banca tem três partes: o modelo global, a tabela de coeficientes e a frase interpretativa.
1. O modelo global. Informe R², R² ajustado, a estatística F com seus graus de liberdade e o p. Algo como: “O modelo explicou parcela significativa da variação da satisfação (R² = 0,34; R² ajustado = 0,31; F(3, 116) = 19,8; p < 0,001).”
2. A tabela de coeficientes. Uma linha por preditor, com B, erro-padrão, beta, t, p e o intervalo de confiança de 95%. A formatação da tabela segue as regras de apresentação tabular da ABNT — título acima, fonte abaixo, sem linhas verticais fechando as laterais —, detalhadas em tabelas e quadros ABNT no Word.
3. A frase interpretativa. É onde a maioria dos TCCs escorrega, por excesso. Um modelo seguro:
“Entre os três preditores, apenas o suporte da chefia apresentou efeito significativo (B = 0,42; IC 95% [0,19; 0,65]; β = 0,38; p < 0,001), indicando que cada ponto a mais na escala de suporte está associado a um aumento de 0,42 ponto na satisfação, controlados tempo de casa e escolaridade.”
Note o verbo: “está associado a”, não “causa”. Em um levantamento transversal, o desenho não autoriza afirmação causal, por mais alto que seja o R². A construção do capítulo em que essa leitura entra está em análise e discussão dos resultados.
Declare ainda, na metodologia, que os pressupostos foram verificados e como. Uma frase basta: “Os pressupostos de linearidade, homocedasticidade e normalidade dos resíduos foram verificados por inspeção gráfica, e a ausência de multicolinearidade por VIF (máximo = 1,84).” Isso é o que separa uma análise conduzida de uma análise improvisada — o mesmo princípio que rege a apresentação de qualquer resultado quantitativo, tratada em análise de dados quantitativos no TCC.
Erros que a banca pega
- Testar normalidade das variáveis em vez dos resíduos — e descartar a regressão por causa disso.
- Relatar R² sem o ajustado em modelo múltiplo.
- Comparar coeficientes B de variáveis em escalas diferentes para dizer qual pesa mais; para isso existe o beta.
- Empilhar preditores sem justificativa teórica, buscando subir o R².
- Escrever “causa” a partir de dados transversais.
- Omitir os pressupostos — o silêncio é lido como “não foram verificados”.
- Ignorar o alerta de multicolinearidade quando o modelo é significativo e nenhum preditor é.
Se o seu problema não é rodar o modelo, mas transformar a saída em texto defensável, o Tesify ajuda a escrever o capítulo de resultados a partir dos números que você já calculou, com as referências no padrão ABNT. O cálculo continua sendo seu e do software estatístico: a ferramenta entra na redação, não na análise.
Perguntas frequentes
Quando usar regressão linear no TCC?
Quando a pergunta é de previsão ou explicação — quanto uma ou mais variáveis explicam da variação de um desfecho numérico — e não apenas se duas variáveis andam juntas. Se a pergunta for apenas de associação, a correlação basta e é mais simples de defender.
Quantos respondentes são necessários para uma regressão múltipla?
As regras de bolso mais citadas são as de Green (1991): pelo menos 50 + 8m respondentes para testar o R² geral, e 104 + m para testar cada preditor individualmente, sendo m o número de preditores. Com 3 preditores isso dá cerca de 74 e 107 respondentes. São aproximações; o cálculo formal de poder é preferível.
A normalidade da regressão é dos dados ou dos resíduos?
Dos resíduos. A regressão linear não exige que a variável dependente nem as independentes tenham distribuição normal — exige que os erros do modelo sejam aproximadamente normais. Testar a normalidade das variáveis brutas e rejeitar a regressão por causa disso é um dos erros mais comuns em TCC.
O que é um R² bom no TCC?
Não existe um valor universal. Em ciências humanas e sociais, R² entre 0,10 e 0,30 é comum e publicável, porque comportamento humano tem muitas causas. Em áreas experimentais espera-se mais. O que importa é comparar com o que a literatura da sua área relata, e não com um número decorado.
O que é VIF e qual valor é aceitável?
O VIF (fator de inflação da variância) mede o quanto um preditor é explicado pelos outros preditores. A convenção mais usada trata VIF acima de 10 como multicolinearidade séria, e parte da literatura adota um limite mais rígido, acima de 5. Valores próximos de 1 indicam ausência de problema.
Regressão prova que uma variável causa a outra?
Não. Regressão estima associação condicional, não causalidade. Em um levantamento transversal, o desenho não permite afirmar causa, por melhor que seja o R². Escreva “está associado a” e “prediz”, nunca “causa”, a menos que o desenho seja experimental.