A regressão logística é o teste estatístico indicado quando a variável que você quer explicar no seu TCC de Psicologia é binária — por exemplo, apresentar ou não sintomas clinicamente significativos de ansiedade, em vez de uma pontuação contínua. Diferente da regressão linear, que prevê um valor numérico, a regressão logística prevê a probabilidade de um evento ocorrer, e seus coeficientes são interpretados por meio do odds ratio (razão de chances). Este guia mostra, passo a passo, quando usar a técnica e como interpretar o odds ratio, com um exemplo numérico resolvido e discutido em detalhe, do início da coleta até a redação do capítulo de resultados e discussão.
Quando usar regressão logística em vez de regressão linear no TCC
Use regressão logística quando a variável dependente do seu TCC for categórica binária: presença ou ausência de um transtorno, abandono ou permanência em terapia, aprovação ou reprovação em um curso, entre outros exemplos. Se a variável dependente for contínua (uma pontuação de escala, por exemplo), a regressão linear continua sendo a escolha adequada. Confundir os dois casos é um dos erros metodológicos mais comuns em TCCs de Psicologia que usam análise quantitativa — rodar uma regressão linear comum com uma variável binária como desfecho pode gerar probabilidades previstas abaixo de 0 ou acima de 1 e viola pressupostos do modelo linear, mesmo que o software não acuse erro algum ao processar o cálculo.
O que é odds ratio e por que ele não é o mesmo que probabilidade
O odds ratio (razão de chances) expressa quantas vezes maior (ou menor) é a chance de o evento ocorrer para cada unidade de aumento na variável preditora, mantendo as demais variáveis do modelo constantes. É importante não confundir chance com probabilidade: um odds ratio de 2,0 não significa que a probabilidade do evento dobra — significa que a razão entre a probabilidade de ocorrer e a probabilidade de não ocorrer dobra. Para eventos raros (probabilidade baixa), essa diferença é pequena na prática; para eventos comuns (probabilidade alta), a diferença entre odds ratio e risco relativo pode ser considerável, e o seu TCC deve declarar essa distinção sempre que discutir o tamanho prático do efeito encontrado.
Por que a regressão logística é tão usada em pesquisa em Psicologia
Muitos dos desfechos mais estudados em Psicologia são naturalmente binários por definição clínica ou operacional: uma pessoa preenche ou não os critérios diagnósticos de um transtorno, permanece ou abandona um tratamento, responde ou não responde a uma intervenção dentro de um critério pré-estabelecido. Transformar esses desfechos em uma variável contínua artificial, só para poder usar uma regressão linear mais familiar, distorce a pergunta de pesquisa original. A regressão logística respeita a natureza categórica do desfecho e ainda permite controlar estatisticamente o efeito de múltiplas variáveis preditoras ao mesmo tempo, o que a torna uma ferramenta particularmente valiosa quando o objetivo do TCC é entender quais fatores, entre vários candidatos, realmente se associam de forma independente ao desfecho estudado, já descontado o efeito das demais variáveis incluídas no modelo.
Passo a passo para aplicar a regressão logística
- Defina a variável dependente binária, codificada como 0 (ausência do evento) e 1 (presença do evento).
- Escolha as variáveis preditoras (independentes) com base no seu referencial teórico, evitando incluir variáveis apenas porque estavam disponíveis no instrumento de coleta.
- Verifique o tamanho da amostra. Uma regra prática comum na literatura é ter pelo menos 10 casos do grupo menos frequente (por exemplo, 10 pessoas com o evento) para cada variável preditora incluída no modelo.
- Rode o modelo no software estatístico (SPSS, R, Jamovi ou similar), obtendo os coeficientes, os odds ratios e os intervalos de confiança de cada variável.
- Verifique o ajuste do modelo (por exemplo, pelo teste de Hosmer-Lemeshow ou por métricas de qualidade de ajuste do software usado) antes de interpretar os coeficientes individuais.
- Interprete cada odds ratio em relação à variável dependente, sempre relatando também o intervalo de confiança e o valor de p.
Exemplo ilustrativo resolvido (dados fictícios)
Considere um estudo fictício investigando fatores associados à busca por atendimento psicológico (variável dependente: buscou atendimento = 1, não buscou = 0) em uma amostra de universitários. Suponha que o modelo de regressão logística encontrou, para a variável pontuação em uma escala de sintomas depressivos (preditora contínua), um odds ratio de 1,15, com intervalo de confiança de 95% entre 1,05 e 1,26, e valor de p menor que 0,05. A interpretação correta é: a cada ponto adicional na escala de sintomas depressivos, a chance de buscar atendimento psicológico aumenta em 15%, mantendo as demais variáveis do modelo constantes — e, como o intervalo de confiança não cruza o valor 1,0, esse efeito é estatisticamente significativo. Se o mesmo modelo fictício encontrasse um odds ratio de 0,80 (com intervalo de confiança inteiramente abaixo de 1,0) para a variável ter plano de saúde com cobertura psicológica (codificada como sim = 1), a interpretação seria: ter plano de saúde com cobertura se associa a uma chance 20% menor de buscar atendimento — um resultado que pareceria contraintuitivo e mereceria discussão cuidadosa à luz da literatura, não apenas ser relatado sem comentário.
Como avaliar a qualidade geral do modelo (discriminação)
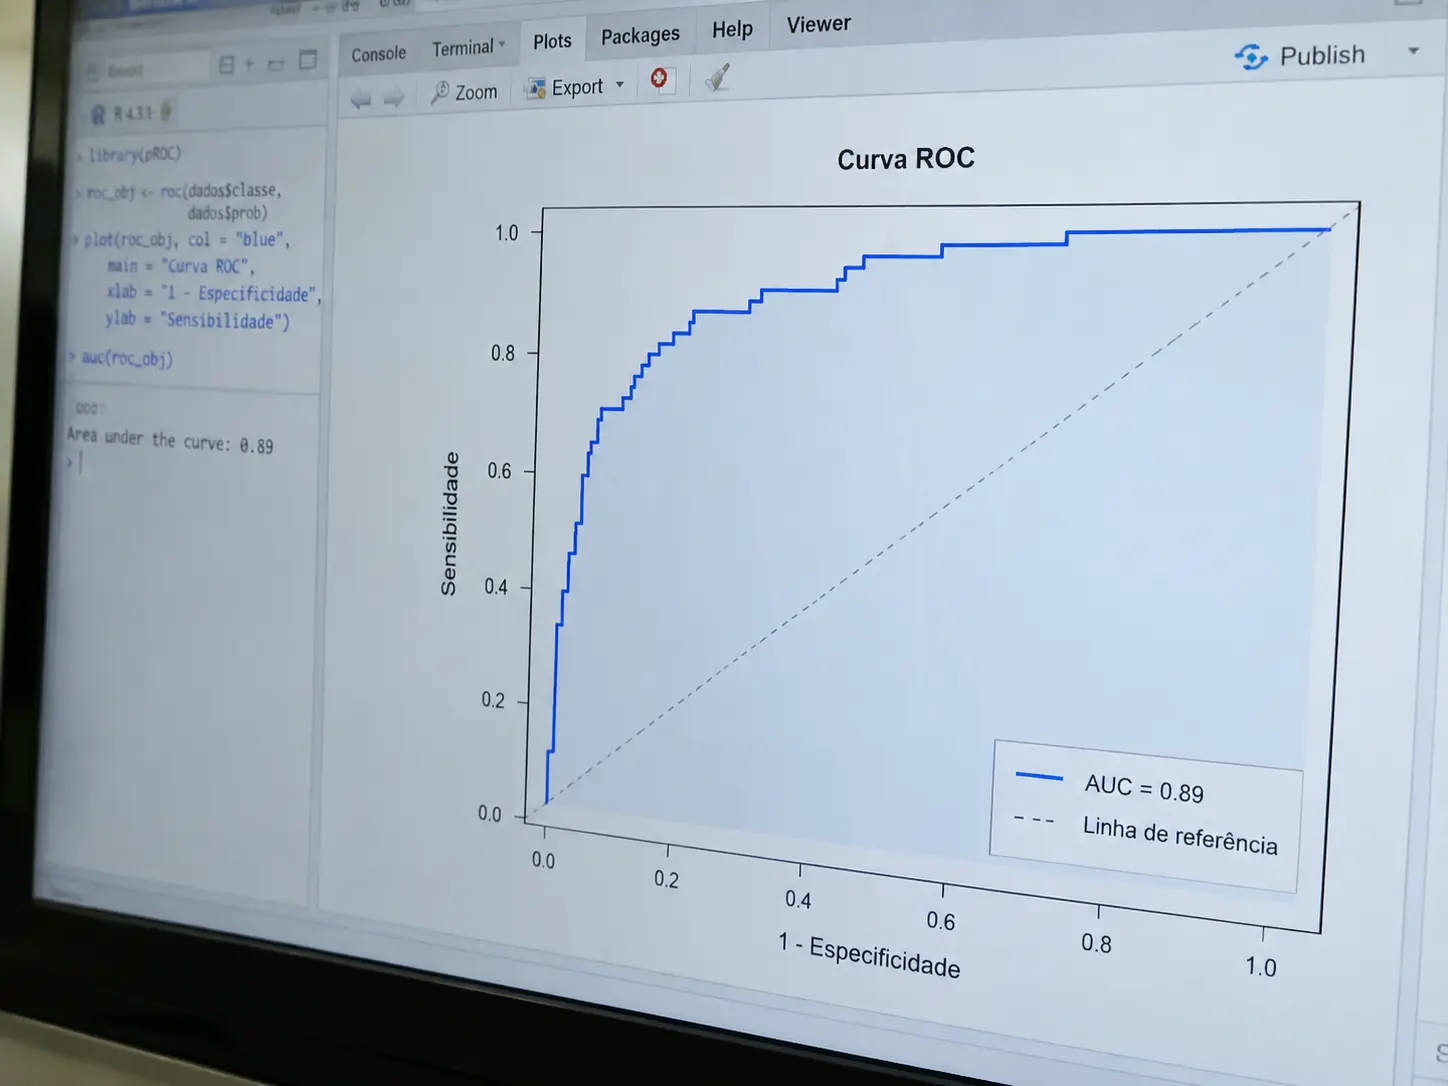
Além de interpretar cada odds ratio individualmente, um capítulo de resultados robusto avalia a capacidade do modelo como um todo de discriminar entre quem apresenta e quem não apresenta o desfecho. Uma das métricas mais usadas para isso é a área sob a curva ROC (AUC): valores próximos de 0,5 indicam que o modelo discrimina pouco melhor que o acaso, enquanto valores mais próximos de 1,0 indicam boa capacidade discriminativa. Reportar a AUC, junto com uma medida de pseudo-R² (como o R² de Nagelkerke, comum em saídas de softwares estatísticos), dá à banca uma visão do modelo como um todo, complementando a interpretação de cada odds ratio isoladamente.
Do exemplo ao problema de pesquisa: uma estrutura completa
Veja como esse exemplo fictício poderia sustentar um problema de pesquisa formulado. Problema de pesquisa: “Quais fatores estão associados à busca por atendimento psicológico entre universitários?” Objetivo geral: identificar, por meio de regressão logística, os fatores associados à busca por atendimento psicológico em uma amostra de universitários. Objetivos específicos: (1) descrever a prevalência de busca por atendimento na amostra; (2) testar a associação entre sintomas depressivos e busca por atendimento; (3) testar a associação entre acesso a plano de saúde e busca por atendimento. Esse encadeamento — da pergunta de pesquisa ao modelo estatístico escolhido — é o que a banca espera encontrar de forma explícita na introdução do TCC.
Como declarar a metodologia no seu TCC
A metodologia precisa declarar: como a variável dependente foi codificada (0 e 1, especificando qual categoria é qual); quais variáveis preditoras foram incluídas e por quê; se o modelo foi construído por método de entrada simultânea (enter) ou por método stepwise, e a justificativa para essa escolha; qual medida de ajuste do modelo foi usada para avaliar a qualidade geral; e qual software e versão foram usados para a análise. Declarar o método de seleção de variáveis é especialmente importante porque métodos automáticos (stepwise) são hoje vistos com ressalva por parte da literatura metodológica, e uma banca mais rigorosa pode questionar essa escolha se ela não for justificada teoricamente.
Erros mais comuns ao usar regressão logística em um TCC
- Confundir odds ratio com risco relativo ou com probabilidade. Um odds ratio de 2,0 não significa duas vezes mais provável no sentido de probabilidade direta — a interpretação correta é em termos de chance.
- Usar regressão logística com uma variável dependente contínua. Se o desfecho não é binário, a técnica adequada é outra (regressão linear, ou regressão logística multinomial/ordinal para categorias múltiplas).
- Não verificar o tamanho da amostra em relação ao número de preditores. Poucos casos do grupo menos frequente em relação ao número de variáveis compromete a estabilidade dos coeficientes estimados.
- Relatar o coeficiente bruto (log-odds) sem converter para odds ratio. O coeficiente bruto da regressão logística é difícil de interpretar diretamente — sempre reporte o odds ratio (exponencial do coeficiente) no capítulo de resultados.
- Não reportar o intervalo de confiança do odds ratio. Reportar apenas o valor pontual, sem o intervalo de confiança, impede avaliar a precisão da estimativa.
- Não reportar nenhuma medida de qualidade geral do modelo. Apresentar apenas os odds ratios individuais, sem uma medida como AUC ou pseudo-R², deixa incompleta a avaliação do modelo como um todo.
Checklist antes de fechar o capítulo de resultados
- A variável dependente é de fato binária, e sua codificação (0/1) está declarada explicitamente?
- O número de casos do grupo menos frequente é suficiente em relação ao número de preditores incluídos?
- Cada odds ratio é reportado junto com seu intervalo de confiança e valor de p?
- O ajuste geral do modelo foi verificado e reportado (AUC, pseudo-R² ou equivalente), não apenas os coeficientes individuais?
- A interpretação de cada odds ratio evita confundir chance com probabilidade?
Perguntas frequentes
Um odds ratio maior que 1 sempre significa que o efeito é estatisticamente significativo?
Não. A significância estatística depende do intervalo de confiança e do valor de p, não apenas do valor do odds ratio. Um odds ratio de 1,5, por exemplo, pode não ser estatisticamente significativo se o intervalo de confiança de 95% cruzar o valor 1,0.
Qual a diferença entre odds ratio e risco relativo?
O risco relativo compara probabilidades diretamente; o odds ratio compara razões de chances (probabilidade de ocorrer dividida pela probabilidade de não ocorrer). Para eventos raros, os dois valores costumam ser próximos; para eventos comuns, podem divergir consideravelmente, e a distinção deve ser declarada na discussão sempre que o desfecho estudado for frequente na amostra.
Quantos casos preciso ter para rodar uma regressão logística no meu TCC?
Uma regra prática frequentemente citada na literatura é ter pelo menos 10 casos do grupo menos frequente da variável dependente para cada variável preditora incluída no modelo, embora esse número possa variar conforme a área e o desenho específico do estudo — vale a pena confirmar com o seu orientador ou com uma referência metodológica específica da sua linha de pesquisa.
Posso usar regressão logística com uma variável dependente com mais de duas categorias?
Sim, mas não é a regressão logística binária descrita neste guia — para desfechos com mais de duas categorias não ordenadas, usa-se a regressão logística multinomial; para categorias ordenadas (como níveis de gravidade), usa-se a regressão logística ordinal, cada uma com sua própria lógica de interpretação dos coeficientes.
O que é a área sob a curva ROC e por que devo reportá-la?
A área sob a curva ROC (AUC) mede a capacidade do modelo de discriminar corretamente entre os casos com e sem o desfecho estudado, em uma escala de 0,5 (discriminação equivalente ao acaso) a 1,0 (discriminação perfeita). Reportá-la, junto com os odds ratios individuais, dá à banca uma visão da qualidade geral do modelo, e não apenas do efeito isolado de cada variável.
Para continuar planejando o seu TCC de Psicologia, veja também qual teste estatístico usar em outros desenhos de pesquisa, como calcular amostra e poder estatístico antes de coletar seus dados, como escrever a metodologia do TCC de Psicologia, e como citar na ABNT o software estatístico usado para rodar o modelo.