A pergunta “qual software usar para analisar minhas entrevistas” costuma ser respondida com uma lista de preços, e é por isso que tanto TCC escolhe errado. A decisão real é anterior: existem duas famílias de software qualitativo que fazem coisas diferentes. Uma organiza a codificação que você faz; a outra classifica o corpus estatisticamente e devolve grupos para você interpretar. Escolher a família errada é um erro de categoria que só aparece quando o prazo já acabou.
As duas famílias, e por que a distinção decide tudo
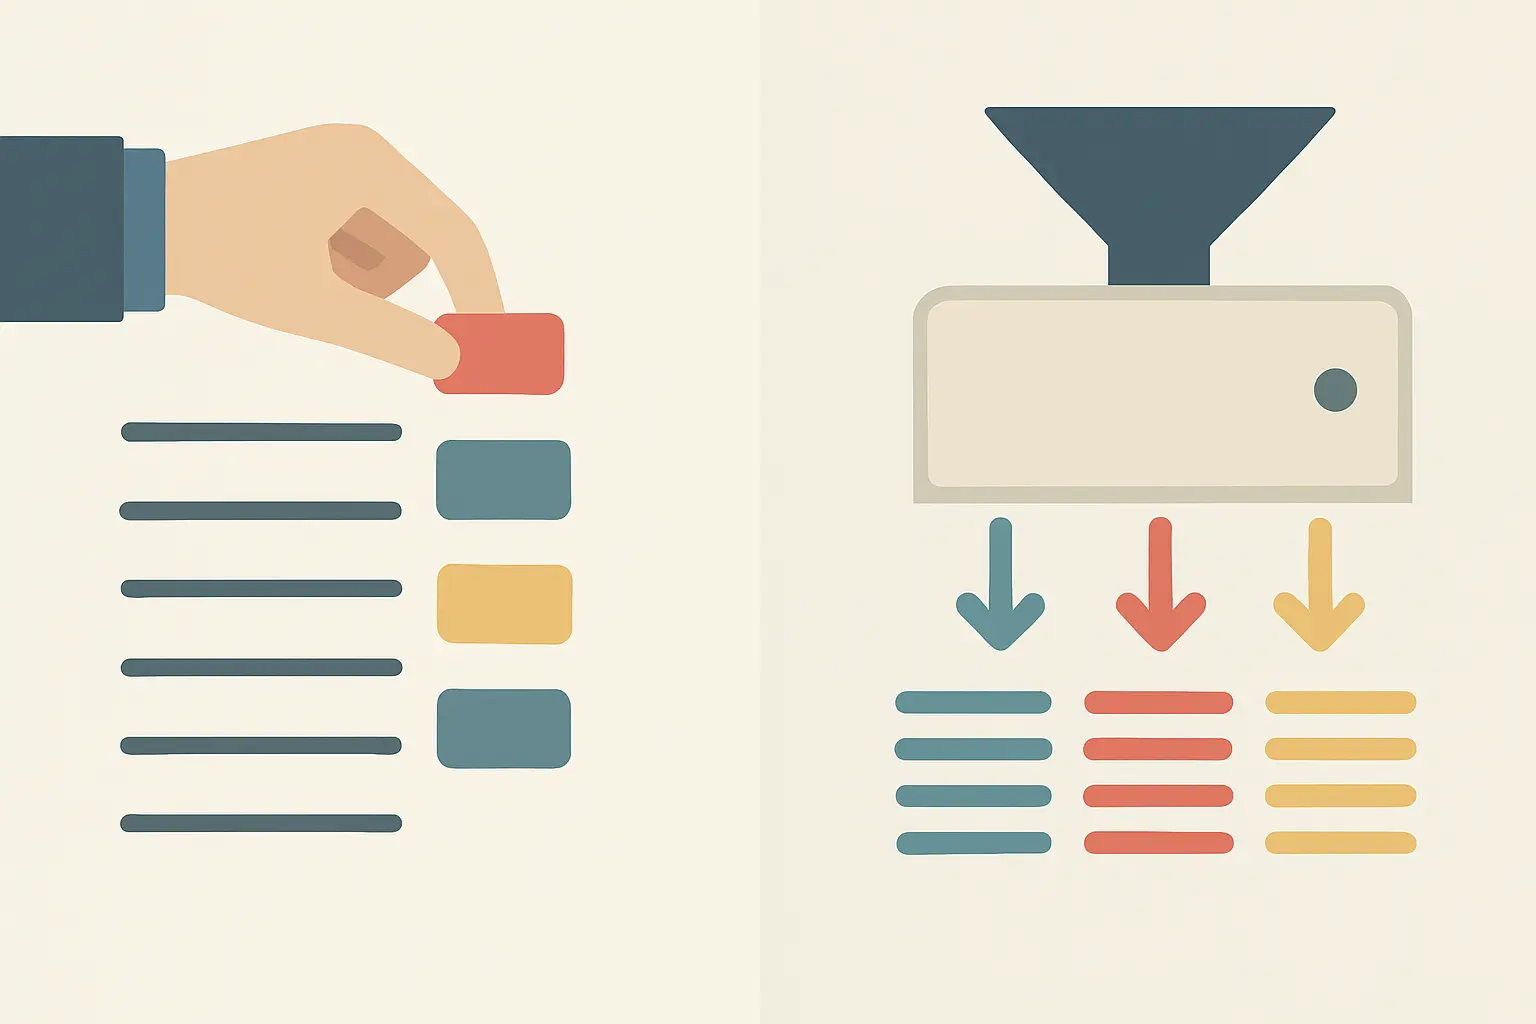
- Software de codificação (CAQDAS). Você lê cada transcrição, marca trechos, atribui códigos, agrupa códigos em categorias. O programa guarda tudo, permite recuperar todos os trechos de uma categoria em um clique, registra as suas anotações analíticas e mostra quem disse o quê. Ele não decide nada — ele torna o seu trabalho rastreável.
- Software de análise lexical estatística. Você entrega o corpus inteiro e o programa o segmenta e classifica por procedimentos estatísticos, devolvendo classes de vocabulário. Você não codifica; você interpreta as classes que saíram e defende por que elas fazem sentido.
Isso muda o que você escreve na metodologia, o que a banca vai arguir e até quantas entrevistas você precisa. Análise lexical estatística pede corpus grande — dezenas de entrevistas, centenas de respostas abertas, milhares de postagens. Codificação funciona bem com oito, dez, quinze entrevistas, que é o volume típico de um TCC e que se define pelo critério discutido em o que é saturação teórica.
Família 1 — Software de codificação (ATLAS.ti, NVivo, MAXQDA)
Os três funcionam sobre a mesma lógica e diferem em detalhes de interface, preço e recursos periféricos. O que todos entregam:
- Marcação de trechos com códigos e recuperação de todos os trechos de um código.
- Memorandos analíticos — as suas anotações ligadas ao trecho que as motivou. É o recurso que mais falta em quem trabalha só com marca-texto no papel.
- Matriz de códigos por participante, que responde à pergunta “esta categoria apareceu em quantas entrevistas?” — número que a banca costuma pedir.
- Rastreabilidade. Cada trecho citado no capítulo de resultados pode ser devolvido à sua origem, o que é a resposta pronta para “de onde saiu essa fala?”.
Diferenças que importam na prática: o ATLAS.ti tem forte tradição em visualização de redes conceituais entre códigos; o NVivo é o mais difundido em programas de pós-graduação e lida com áudio, vídeo e material de redes sociais além de texto; o MAXQDA é o mais confortável em desenhos mistos, integrando dados de survey com material textual. Todos os três são de licença paga, e é aí que a decisão costuma travar — vale verificar se o seu programa de pós-graduação já tem licença institucional antes de descartar qualquer um.
Importante: nenhum deles cria categorias por você. O método continua sendo o seu — as três fases e as regras de categorização estão em análise de conteúdo de Bardin passo a passo.
Família 2 — Análise lexical estatística (IRaMuTeQ)
O IRaMuTeQ é a alternativa livre mais usada no Brasil, e o nome diz o que ele é: Interface de R pour les Analyses Multidimensionnelles de Textes et de Questionnaires. Segundo o site oficial do projeto, é software livre distribuído sob a licença GNU GPL versão 2, construído sobre o R e o Python, desenvolvido por Pierre Ratinaud e mantido no LERASS.
As análises que ele oferece sobre corpus textual, conforme a documentação do próprio projeto:
- Classificação Hierárquica Descendente pelo método descrito por Reinert (1983, 1991), cruzando formas plenas e segmentos de texto. É o carro-chefe: o corpus é dividido em classes de vocabulário que tendem a aparecer juntas.
- Pesquisa de especificidade a partir de uma segmentação definida — por exemplo, quais palavras caracterizam as falas dos gestores em relação às dos operadores.
- Estatísticas textuais clássicas.
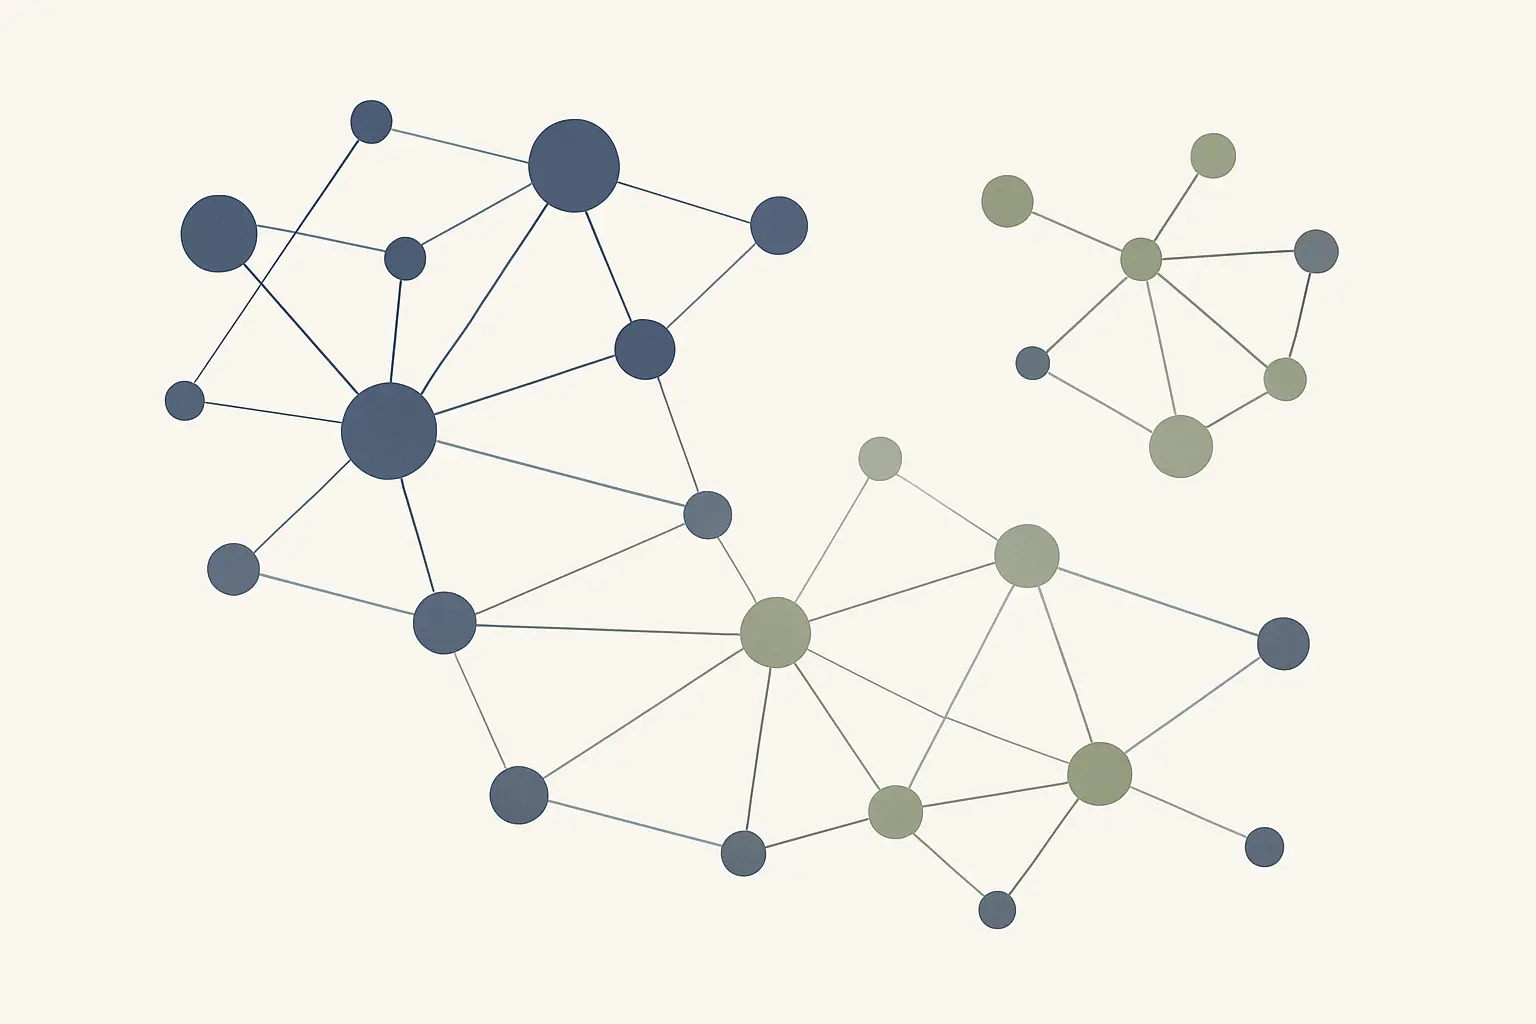
- Análise de similitude sobre as formas plenas do corpus segmentado, que produz a rede de coocorrência entre termos.
Ele também analisa tabelas de indivíduos por características, com classificação hierárquica descendente e descrição por qui-quadrado. Duas advertências honestas: por rodar sobre R e Python, a instalação exige atenção e é onde a maioria desiste; e o corpus precisa estar em um arquivo de texto com marcação de variáveis no formato que o programa espera, o que impõe uma etapa de preparação que a família anterior não tem.
E o ponto metodológico decisivo: uma classe produzida pela classificação estatística não é uma categoria de análise de conteúdo. Ela é um agrupamento de vocabulário que você precisa nomear, justificar teoricamente e, muitas vezes, descartar quando não fizer sentido. Apresentar as classes do programa como se fossem resultado final é o erro que a banca pega.
A opção que ninguém recomenda e que funciona
Para oito a quinze entrevistas — o corpus típico de um TCC de graduação —, uma planilha bem estruturada resolve, e resolve rápido. Monte uma tabela com colunas para participante, excerto, unidade de registro, categoria e subcategoria, e você tem rastreabilidade, contagem por categoria e recuperação por filtro.
Não há prejuízo metodológico nisso. O que se avalia é a clareza do procedimento, não o software — e uma análise manual bem descrita é aceita sem ressalvas. A vantagem adicional é o tempo: instalar, aprender e configurar um CAQDAS consome dias que, num corpus pequeno, não se pagam.
Comparativo lado a lado
| Critério | ATLAS.ti | NVivo | MAXQDA | IRaMuTeQ | Planilha |
|---|---|---|---|---|---|
| Família | Codificação | Codificação | Codificação | Análise lexical | Codificação manual |
| Custo | Licença paga | Licença paga | Licença paga | Livre, GNU GPL v2 | Já disponível |
| Quem cria as categorias | Você | Você | Você | O algoritmo propõe classes | Você |
| Tamanho de corpus ideal | Médio a grande | Médio a grande | Médio a grande | Grande | Pequeno |
| Curva de instalação | Baixa | Baixa | Baixa | Alta (depende de R e Python) | Nenhuma |
| Áudio e vídeo | Sim | Sim | Sim | Não | Não |
| Memorandos analíticos | Sim | Sim | Sim | Não é a proposta | Manual |
| Saída característica | Redes de códigos | Matrizes e consultas | Integração quali-quanti | Dendrograma e rede de similitude | Quadro de categorias |
Quanto cada um é usado em teses brasileiras
Adoção declarada é um critério legítimo de escolha: usar o que a sua área usa facilita achar tutorial, orientação e parecer favorável. Para medir isso, consultei a Biblioteca Digital Brasileira de Teses e Dissertações (BDTD) em 16 de agosto de 2026, quando o acervo somava 1.139.795 registros. Buscando cada ferramenta em todos os campos:
| Ferramenta | Registros |
|---|---|
| ATLAS.ti | 1.429 |
| NVivo | 1.156 |
| Alceste | 497 |
| IRaMuTeQ | 437 |
| MAXQDA | 308 |
Três leituras. Primeira: ATLAS.ti e NVivo dominam a produção brasileira em análise qualitativa assistida por computador, com folga sobre o MAXQDA. Segunda: o IRaMuTeQ, sendo gratuito e mais recente, já supera o MAXQDA — uma inversão relevante para quem não tem licença institucional. Terceira, e mais importante metodologicamente: esses números têm ruído e você não deve reproduzi-los sem a ressalva. A busca por Alceste, por exemplo, recupera também teses de Letras sobre a personagem de Molière e sobre a tragédia grega. Contagens por nome de ferramenta são estimativas de ordem de grandeza, não censos — o assunto é tratado com mais detalhe em estudo bibliométrico no TCC.
Veredito por perfil de pesquisa
- 8 a 15 entrevistas, análise de conteúdo, prazo curto: planilha. Instalar um CAQDAS não se paga nesse volume.
- Corpus médio, análise de conteúdo, licença institucional disponível: ATLAS.ti, NVivo ou MAXQDA — use o que a sua instituição fornece e o seu orientador conhece.
- Corpus grande de respostas abertas, postagens ou documentos, sem licença: IRaMuTeQ.
- Desenho misto com survey e texto no mesmo estudo: MAXQDA, se houver licença; caso contrário, planilha para o texto e software estatístico para os números, conforme SPSS, R, Jamovi ou Excel para analisar dados do TCC.
- Análise de discurso: nenhum dos anteriores é obrigatório, porque o objeto é outro — as condições de produção do sentido, tratadas em análise de discurso passo a passo.
Como declarar o software na metodologia
“As transcrições foram organizadas e codificadas com auxílio do software ATLAS.ti (versão X). A codificação seguiu a análise de conteúdo na perspectiva de Bardin (2011), com o tema como unidade de registro e categorização emergente. O software foi utilizado para organização, recuperação e rastreabilidade dos excertos, não tendo participado da definição das categorias.”
“O corpus, composto por 62 respostas discursivas, foi processado no IRaMuTeQ (versão X), software livre sob licença GNU GPL. Aplicou-se a Classificação Hierárquica Descendente pelo método de Reinert e a análise de similitude. As classes resultantes foram nomeadas e interpretadas pela pesquisadora à luz do referencial teórico adotado.”
Repare no que as duas frases têm em comum: elas delimitam o papel do software. Essa é a frase que evita a pergunta mais desconfortável da arguição, e ela vale também quando você usou apoio de inteligência artificial em alguma etapa — os limites estão em IA para analisar dados do TCC.
Erros de escolha que custam semanas
- Escolher IRaMuTeQ para 10 entrevistas. A classificação estatística precisa de corpus; com pouco material as classes saem instáveis e indefensáveis.
- Escolher um CAQDAS pago para depois descobrir que a licença expira em 14 dias, no meio da codificação. Confirme a licença institucional antes de começar a codificar.
- Apresentar as classes do IRaMuTeQ como categorias de análise de conteúdo, sem interpretá-las nem nomeá-las.
- Começar a codificar sem transcrição revisada. Codificar sobre uma transcrição automática não conferida propaga o erro para toda a análise — o cuidado está em como transcrever entrevistas com IA para o TCC.
- Deixar a escolha do software para depois da coleta, quando ela já deveria estar declarada no projeto e, em parte, condiciona quantos participantes você precisa — decisão discutida em grupo focal e entrevista semiestruturada no TCC.
Escolhida a ferramenta e concluída a codificação, sobra a parte que nenhum desses programas faz: escrever o capítulo que interpreta as categorias e o amarra ao referencial teórico. É onde o Tesify ajuda, estruturando o texto do TCC a partir do seu próprio material, com referências ABNT automáticas e autoverificação de originalidade.
Perguntas frequentes
Qual o melhor software para analisar entrevistas no TCC?
Depende do tipo de análise. Para análise de conteúdo com categorias construídas pelo pesquisador, um software de codificação como ATLAS.ti, NVivo ou MAXQDA. Para análise lexical estatística de um corpus grande, o IRaMuTeQ. Para um corpus pequeno, de 8 a 15 entrevistas, uma planilha bem organizada resolve.
O IRaMuTeQ é gratuito?
É. Segundo o site oficial do projeto, é software livre distribuído sob a licença GNU GPL versão 2, construído sobre o R e o Python, desenvolvido por Pierre Ratinaud e mantido no LERASS.
Preciso de software para fazer análise de conteúdo?
Não. O método pode ser aplicado integralmente de forma manual, com planilhas e material impresso anotado. O software organiza e dá rastreabilidade, mas não é requisito metodológico, e bancas de graduação aceitam análises manuais desde que os procedimentos sejam descritos com clareza.
Qual a diferença entre IRaMuTeQ e NVivo?
São lógicas diferentes. No NVivo é o pesquisador que lê e codifica trecho por trecho, e o programa organiza esse trabalho. No IRaMuTeQ é o programa que classifica estatisticamente os segmentos de texto, pela classificação hierárquica descendente, e cabe ao pesquisador interpretar as classes resultantes.
Quantas teses brasileiras usam cada software?
Em consulta à BDTD feita em 16 de agosto de 2026, sobre um acervo de 1.139.795 registros, os resultados foram 1.429 para ATLAS.ti, 1.156 para NVivo, 497 na busca por Alceste, 437 para IRaMuTeQ e 308 para MAXQDA. São estimativas de ordem de grandeza: buscas por nome de ferramenta recuperam também registros homônimos.
O software substitui a interpretação do pesquisador?
Não. Nenhuma dessas ferramentas decide o que uma categoria significa. Elas organizam, contam e agrupam; o rigor analítico depende do pesquisador, e é a interpretação que a banca avalia.
Posso usar dois softwares no mesmo trabalho?
Pode, e em desenhos mistos isso é comum — por exemplo, análise lexical do corpus completo para mapear o terreno e codificação de um subconjunto para aprofundar. O que se exige é declarar cada ferramenta, o que foi feito em cada uma e por que a combinação foi escolhida.